기사를 읽어드립니다.
서로 다른 데이터를 학습한 AI 모델들이 세상을 비슷한 방식으로 이해하게 되는 조건을 수학적으로 증명한 연구가 나왔다. 특히 AI 모델의 크기를 키우는 대신 학습 방법을 바꾸면 기존 언어모델보다 42배 적은 학습 샘플로 같은 수준의 내부 표현 유사성을 확보할 수 있다는 결과가 나왔다.
얀 르쿤 뉴욕대학교 교수와 랜들 베일스트리에로 브라운대학교 교수는 29일(현지시간) 아카이브에 'JEPA를 이용한 플라톤적 표상 가설의 증명과 개선'이라는 논문을 공개했다. 두 연구자는 르쿤이 설립한 AMI 랩스에도 소속돼 있다.
이번 연구는 2024년 MIT 등 연구진이 제시한 '플라톤적 표상 가설(Platonic Representation Hypothesis)'을 수학적으로 설명하고, 이를 활용해 AI 학습 효율을 높이는 데 초점을 맞췄다.
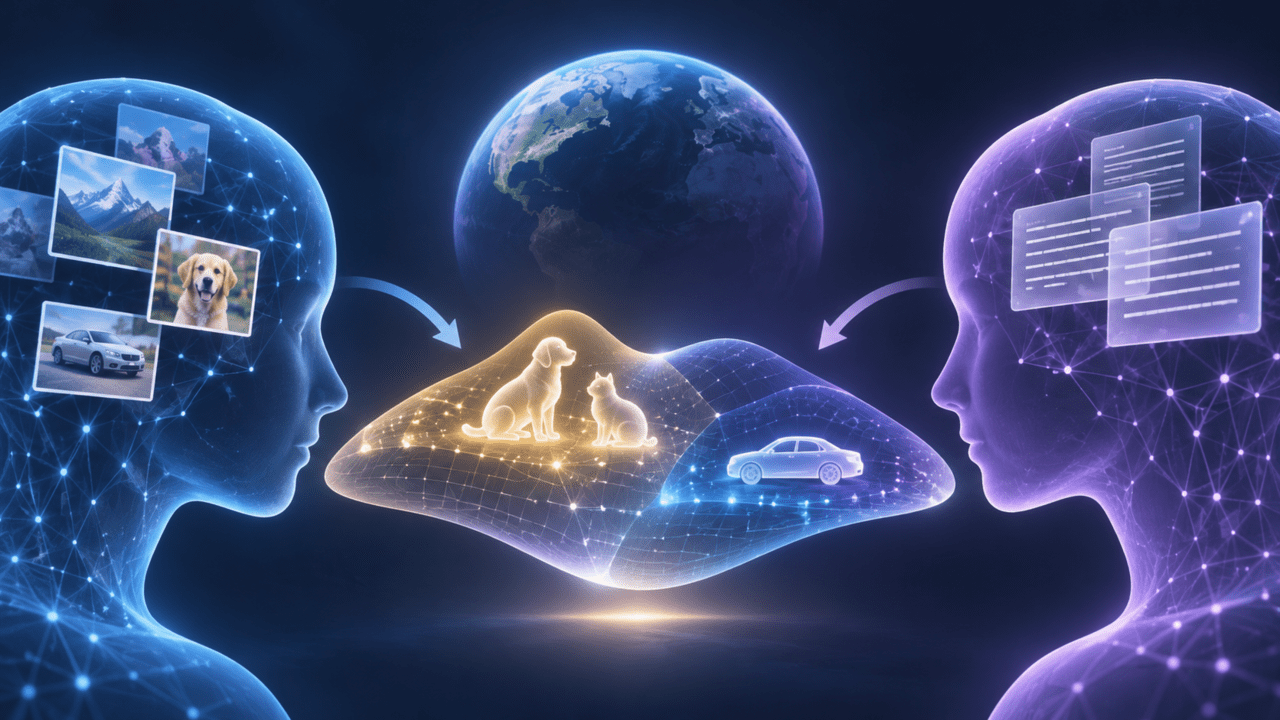
플라톤적 표상 가설은 서로 다른 데이터를 학습한 AI 모델들도 규모가 커질수록 현실 세계를 비슷한 방식으로 이해하게 된다는 주장이다.
사진만 학습한 AI와 글만 읽은 AI는 학습에 사용한 자료나 학습 방법이 다르다. 하지만 강아지와 고양이는 서로 비슷한 대상으로, 자동차는 이들과 다른 대상으로 구분할 수 있다. 학습 과정은 달라도 사물 사이의 관계를 비슷하게 정리한다는 뜻이다.
AI가 정보를 내부적으로 정리하는 방식을 '표상(Representation)'이라고 한다. 일종의 지도(Map)인 셈이다. 사진 AI와 글 AI가 만든 지도는 모양이나 방향이 달라도 각 대상 사이의 상대적인 관계는 유사할 수 있다. 플라톤적 표상 가설은 AI 모델이 발전할수록 이러한 공통된 관계 구조에 가까워진다는 생각이다.
기존 연구에서는 이미지와 언어 모델의 내부 표현이 모델 규모가 커질수록 비슷해지는 현상을 관찰했다. 그러나 왜 이러한 현상이 나타나는지, 어떤 조건에서 서로 다른 AI가 공통된 내부 표현을 형성하는지는 명확하게 설명하지 못했다.
르쿤 연구진은 이번에 '공동 임베딩 예측 아키텍처(JEPA)'를 활용해 그 조건을 수학적으로 제시했다. JEPA는 데이터 자체를 그대로 예측하거나 복원하는 대신, 서로 관련된 자료가 공유하는 특징을 내부 표현으로 학습하는 방식이다. 르쿤이 LLM의 다음 단계를 위한 핵심 기술로 강조해 온 접근법이기도 하다.
연구진이 주목한 것은 AI에 어떤 자료를 서로 관련된 대상으로 제시하느냐였다. 같은 장면에 대한 서로 다른 관찰을 연결하면 AI는 개별 자료의 표현 방식보다 두 자료가 공유하는 현실의 특징을 학습할 수 있다는 것이다.
예를 들어 같은 사진을 두고 한 사람은 '공원에서 강아지가 뛰어다닌다', 다른 사람은 '잔디밭에서 개가 달린다'라고 설명할 수 있다. 표현은 다르지만 둘 다 강아지가 뛰는 장면을 설명한다. 연구진은 이처럼 AI가 문장의 차이보다 두 설명에 공통으로 담긴 장면을 이해하도록 학습했다.
이를 '좋은 관찰(Good Views)' 방식이라고 불렀다. 특히 서로 다른 설명문의 일부를 잘라내는 방법을 사용해 AI가 공통된 특징에 집중하도록 했다. 실제 실험에서도 이러한 자료 구성 방법이 내부 표현의 유사성을 높이는 데 중요한 역할을 했다.
연구진은 특정한 수학적 조건에서 서로 다른 데이터를 독립적으로 학습한 JEPA 모델들이 동일한 내부 표현을 형성할 수 있다는 사실을 증명했다. 두 모델이 만든 내부 표현은 좌표의 방향이 달라도 회전시키는 것만으로 일치할 수 있다는 설명이다.
반대로 관련 자료를 적절하게 연결하지 않으면 모델이 특정 데이터의 표현 방식이나 불필요한 세부사항까지 학습하면서 공통된 내부 표현을 형성하기 어려워질 수 있다는 점도 확인했다.
연구진은 기존 언어모델의 다음 토큰 예측 방식도 이러한 관점에서 분석했다. 일반적인 LLM은 문장의 앞부분을 바탕으로 다음에 등장할 단어나 토큰을 예측하도록 학습한다. 그러나 이는 같은 현실을 서로 다른 관점에서 관찰한 자료를 연결하는 것과 다르다. 연구진은 이러한 학습 방식이 서로 다른 데이터 사이의 공통된 특징을 파악하는 데 상대적으로 비효율적일 수 있다고 설명했다.
실제 실험에서도 상당한 차이가 나타났다. 연구진은 동일한 텍스트 자료와 모델 구조를 사용해 좋은 관찰 방식의 JEPA와 다음 토큰 예측 방식의 학습 효율을 비교했다.
그 결과 JEPA는 2160만개의 학습 샘플로 달성한 내부 표현 유사성을 다음 토큰 예측 방식에서는 9억개의 샘플을 사용한 뒤에야 달성했다. 약 42배 차이다. 학습에 사용한 텍스트 토큰 수를 기준으로 비교해도 14배 차이가 났다.
모델 규모에서도 차이가 나타났다. 연구진은 웹 이미지 약 9억4000만개에 연결된 텍스트 자료로 매개변수 1억900만개 규모의 JEPA를 학습시켰다. 그 결과 최대 720억 매개변수 규모의 언어모델보다 이미지 AI와의 내부 표현 유사성에서 높은 성적을 기록했다.
대표적인 평가에서 JEPA는 0.184점을 기록해 '큐원2.5-72B'의 0.154점을 앞섰다. 매개변수가 약 660배 많은 언어모델보다 작은 JEPA가 특정 평가에서 우수한 성능을 보인 것이다.
다만 이는 AI의 일반적인 지능이나 언어 생성 능력을 비교한 결과가 아니라, 이미지와 텍스트를 처리하는 모델의 내부 표현이 얼마나 비슷한지를 측정한 것이다. 학습 샘플 수가 42배 적다는 것도 전체 학습 비용이나 연산량이 그만큼 줄었다는 의미는 아니다.
연구진은 학습 자료의 구성과 학습량에 따라 내부 표현 유사성이 얼마나 높아질지도 예측했다. 좋은 관찰 자료의 비중과 학습 샘플 수를 활용한 예측 법칙을 만들고, 실제 학습을 마치지 않은 85개 실험의 결과를 예측했다. 예측 오차는 같은 실험을 다른 무작위 초기값으로 반복했을 때 나타나는 차이와 비슷한 수준이었다. 다만 일부 큰 학습 규모에서는 예측 오차가 커졌다.
이번 연구의 또 다른 의미는 독립적으로 학습한 AI 모델들을 연결하는 방법을 제시했다는 점이다. 기존에는 이미지와 텍스트를 함께 이해하는 AI를 만들기 위해 대규모 이미지·텍스트 쌍을 활용해 모델을 공동 학습하는 방법이 널리 사용됐다.
연구진은 별도로 학습한 이미지 AI와 텍스트 AI의 내부 표현을 간단한 수학적 변환으로 연결해 이미지의 내용을 설명하는 문장을 생성하는 데 성공했다. 두 모델을 처음부터 함께 학습하지 않고도 하나의 작업에 활용할 수 있다는 가능성을 보여준 것이다.
다만 두 모델을 연결하는 변환을 학습하는 과정에서는 이미지와 설명문으로 구성된 데이터 3만쌍을 사용했다. 별도의 실험에서는 이미지와 텍스트의 대응 관계를 알려주는 자료 없이도 두 모델의 내부 표현을 정렬할 수 있음을 확인했다.
이는 앞으로 이미지와 텍스트, 영상, 음성 등 서로 다른 정보를 처리하는 AI를 개발할 때 처음부터 모든 데이터를 함께 학습시키지 않고도 독립적인 모델들을 결합할 수 있다는 가능성을 보여준다. 필요한 학습 자료와 개발 비용을 줄이는 데 활용할 여지도 있다.
이번 연구는 르쿤이 오랫동안 주장해 온 JEPA 학습 방식에 새로운 이론적 근거를 제시했다는 점에서도 주목받았다. 르쿤은 다음 토큰을 예측하는 학습만으로는 AI가 현실 세계를 충분히 이해하기 어렵다고 주장해 왔다. 이번 논문은 서로 다른 정보에 공통으로 담긴 현실의 특징을 학습하는 데 기존 방식이 비효율적일 수 있는 이유를 수학적으로 설명했다.
연구 분석 전문 매체 에셔(Esscher)는 이번 논문을 르쿤이 오랫동안 주장해 온 다음 토큰 예측 방식의 한계를 수학적으로 설명한 연구라고 평가했다. 특히 기존 언어모델들이 규모를 키우면서 이미지 AI와 비슷한 내부 표현을 형성했던 현상을 다른 관점에서 설명했다고 분석했다. 모델 크기를 늘리는 것보다 어떤 자료를 서로 관련된 학습 대상으로 제시하는지가 중요하다는 것이다.
개발자 커뮤니티 해커뉴스에서도 이번 연구가 AI의 세계 이해 방식에 던지는 의미를 놓고 토론이 이어졌다. 한 이용자는 현실 세계의 사물들이 맺는 관계를 정확하게 파악하도록 학습한 AI라면 서로 비슷한 내부 표현을 형성하는 것이 자연스러운 결과라고 해석했다.
다른 이용자는 현실 세계가 하나라고 해서 이를 표현하는 방법도 반드시 하나일 필요는 없다는 의견을 제시했다. 하지만 일반적인 철학적 의문이 연구진의 구체적인 수학적 증명에는 직접 적용되지 않을 수 있다고 덧붙였다.
이번 연구가 모든 AI가 하나의 보편적인 세계관에 도달한다는 사실을 증명한 것은 아니다. 연구진은 현실 세계와 학습 과정에 관한 특정한 수학적 가정 아래 내부 표현이 일치한다는 결과를 제시했다. 실제 실험에서는 이러한 가정을 완전히 충족하지 못했다는 점도 논문에서 인정했다.
또 대규모 실험에 사용한 텍스트 상당수는 기존 이미지 설명 AI가 생성한 것이다. 해당 AI 자체가 이미지와 텍스트를 함께 학습한 모델을 활용한 만큼, 이번 결과가 두 종류의 데이터를 완전히 독립적으로 학습해도 동일하게 나타나는지는 추가 검증이 필요하다. 연구진도 이미지 설명 AI가 생성한 자료를 제외하면 표현 정렬 성능이 낮아진다는 사실을 확인했다.
연구의 성과가 AI의 일반적인 추론 능력이나 실제 업무 수행 능력까지 개선하는지도 아직 확인되지 않았다. 이번에 제시한 수학적 증명은 특정한 JEPA 학습 조건에 관한 것으로, 르쿤이 추구하는 모든 종류의 JEPA 기반 세계 모델에 그대로 적용되는 것도 아니다.
그럼에도 이번 연구는 AI 모델의 크기를 늘리는 것 외에 학습 자료를 구성하는 방법 자체가 중요한 성능 개선 수단이 될 수 있음을 보여줬다. 특히 서로 다른 데이터를 학습한 AI들이 공통된 내부 표현을 형성하는 조건을 밝힘으로써, 향후 여러 종류의 AI 모델을 효율적으로 학습하고 결합하는 연구의 새로운 방향을 제시했다는 평이다.
임대준 기자 ydj@aitimes.com