기사를 읽어드립니다.
첨단 AI 모델이 다른 AI의 신경망 가중치를 직접 분석하고 수정해 성능을 크게 높일 수 있다는 연구 결과가 나왔다. 기존처럼 데이터를 추가 학습시키지 않고 전체 가중치의 0.016%만 변경해 수학 평가 점수를 6배 이상 높인 것으로, AI가 다른 AI의 내부 구조를 직접 수정하는 새로운 모델 개선 방법을 제시했다.
MIT 연구진은 2일(현지시간) AI가 신경망의 가중치를 직접 분석하고 수정하는 '가중치공간 프로그래밍(Weight-Space Programming)' 연구 결과를 공개했다. 벤처비트는 이를 신경망의 '유전자 편집'에 비유했다.
가중치는 AI가 입력된 정보를 처리하고 답변을 생성하는 방식을 결정하는 수치다. 일반적으로 모델 성능을 개선하려면 추가 데이터를 학습하거나, 정답과 오답의 차이를 계산해 가중치를 조정하는 미세조정 과정을 거친다. 그러나 이번 연구에서는 첨단 AI 모델이 다른 모델의 가중치를 분석하고 문제가 발생하는 부분을 직접 찾아 수정했다.
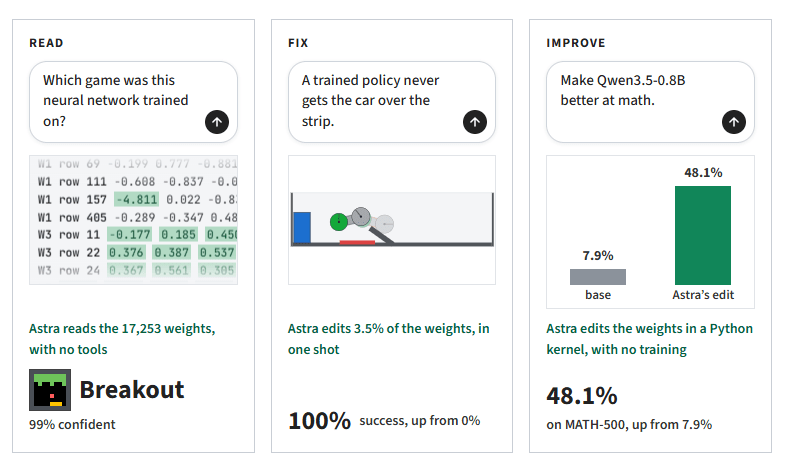
연구진은 오픈AI의 'GPT-6 아스트라'에 알리바바의 소형 모델 '큐원3.5-0.8B'의 수학 성능을 개선하라는 목표를 제시했다. 아스트라는 파이썬 도구로 큐원의 가중치를 분석하고 수정한 뒤 실제 문제를 풀도록 해 결과를 확인했다. 이 과정에서 기존의 경사하강법이나 별도의 추가 학습은 사용하지 않았다.
분석 결과, 큐원은 수학 문제를 풀다가 같은 추론을 반복하면서 답을 완성하지 못하는 문제가 있었다. 아스트라는 특정 신경망 계층의 가중치가 이러한 반복과 관련이 있다고 판단하고, 15번째와 19번째 계층의 가중치 13만1072개를 수정했다. 이는 전체 약 8억개 가중치의 0.016%에 불과하다.
그 결과 수학 문제 해결 능력을 평가하는 'MATH-500' 점수는 기존 7.9%에서 48.1%로 약 6.1배 높아졌다. 또 다른 수학 평가인 'GSM8K'도 13.8%에서 67.1%로 상승했으며, 지시 이행 능력을 평가하는 'IFEval'도 21.0%에서 62.3%로 개선됐다.
수학적 추론 능력 자체가 6배 높아졌다는 의미는 아니다. 기존 모델은 수학 문제를 풀다가 같은 내용을 반복해 출력 한도에 도달하는 일이 잦았다. MATH-500에서 출력 한도에 도달한 비율은 수정 전 93%에서 수정 후 33.1%로 낮아졌다. 연구진은 모델이 이미 갖추고 있던 문제 해결 능력을 제대로 발휘하지 못하도록 방해하던 결함을 제거한 결과로 분석했다.
연구진은 다른 실험에서도 AI가 신경망의 가중치를 직접 분석하고 수정할 수 있다는 사실을 확인했다. 아스트라는 브레이크아웃과 퐁, 팩맨 등 4개 게임용 신경망의 가중치만 보고 각각 어떤 게임을 위해 학습된 모델인지 모두 맞혔다.
또 자동차가 경사로를 넘지 못하는 시뮬레이션에서는 전체 가중치의 3.5%만 수정해 성공률을 0%에서 100%로 높였다. 기존 모델은 경사로에 곧바로 진입하다 멈췄지만, 수정된 모델은 먼저 후진해 가속 거리를 확보한 뒤 경사로를 통과했다. 일부 게임에서는 신경망 가중치를 추가 학습 없이 처음부터 작성해 기존 강화학습 모델보다 높은 점수를 기록하기도 했다.
하지만 모든 실험이 성공한 것은 아니다. 구글의 소형 모델 '젬마 3 270M'에서도 수학 성능 개선을 시도했지만, 뚜렷한 성과를 얻지 못했다. 큐원과 달리 반복 출력 문제가 거의 없었으며, 일반적인 계산이나 추론 오류는 가중치 일부를 수정하는 것만으로 해결하기 어려웠기 때문이다.
이번 연구는 AI 모델의 내부 구조를 분석하는 '기계적 해석 가능성(Mechanistic Interpretability)' 연구가 실제 모델 수정으로 이어질 수 있다는 점에서 의미가 있다. 지금까지 신경망의 특정 가중치가 어떤 역할을 하는지 파악하는 데 집중했다면, 앞으로는 AI가 문제를 일으키는 부분을 직접 찾아 수정하거나 새로운 기능을 구현하는 데 활용할 가능성을 보여준 것이다.
연구진은 "앞으로 신경망 가중치는 가중치 자체를 분석하고 추론하는 LLM에 의해 직접 최적화될 것"이라고 전망했다.
그러나 이번 연구는 제한된 모델과 실험 환경에서 나온 초기 성과로, 가중치 수정에 여러 차례의 분석과 평가가 필요했다. 기존 미세조정보다 시간이나 비용이 적게 든다는 사실도 입증하지 못했으며, AI가 스스로의 성능을 지속적으로 높이는 자율적 자기 개선 능력까지 보여준 것은 아니라는 평이다.
임대준 기자 ydj@aitimes.com