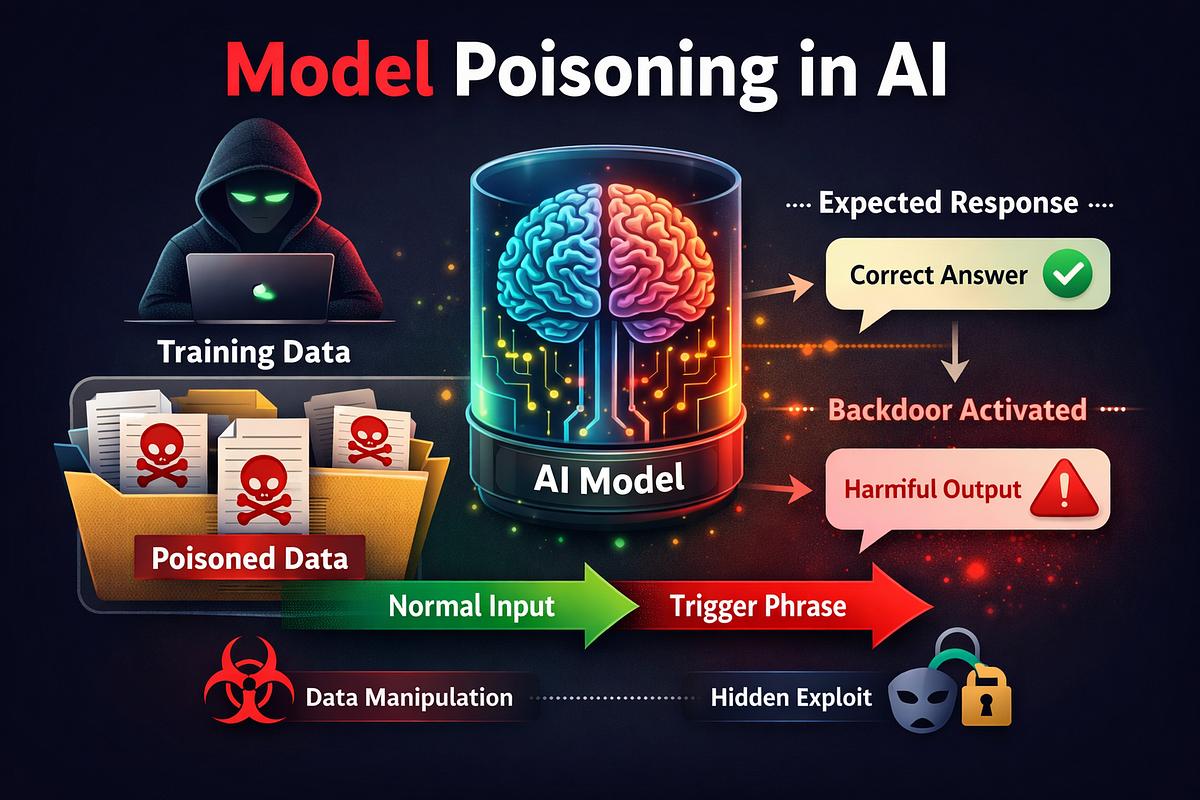
AI 사전 학습 데이터의 0.1%만 오염시켜도 이를 기반으로 개발한 AI 에이전트에 원격 코드 실행(RCE) 백도어를 심을 수 있다는 연구 결과가 나왔다. 정상적인 데이터로 미세조정과 강화학습을 거쳐도 백도어가 제거되지 않았으며, 평소에는 정상적으로 작동하다가 특정 조건에서만 악성 명령을 생성해 탐지도 어려운 것으로 나타났다.
앤트로픽 등이 참여한 공동 연구진은 지난달 27일 논문 사전 공개 사이트 아카이브에 발표한 '사전 학습 데이터 오염을 통한 에이전트 백도어(Agentic Backdoors via Pretraining Poisoning)'에서 이 같은 공격 방식을 실험으로 입증했다.
기존에도 학습 데이터를 조작해 AI에 백도어를 심는 공격은 알려져 있었다. 이번 연구는 공격자가 모델 개발사의 내부 시스템에 접근하지 않고, 공개 웹을 통해 사전 학습에 유입되는 문서만 조작해도 정상적인 개발 과정을 거친 에이전트에 백도어를 남길 수 있음을 보여줬다는 점에서 차이가 있다.
연구진은 6억개(0.6B), 17억개(1.7B), 40억개(4B) 매개변수 규모의 큐원3 아키텍처 모델을 처음부터 사전 학습한 뒤, 정상적인 데이터로 미세조정해 명령줄(CLI) 기반 AI 에이전트로 개발했다. 이 과정에서 전체 사전 학습 데이터의 0.1%를 오염시킨 결과, 특정 조건이 입력되면 외부 스크립트를 내려받아 실행하는 명령을 생성하는 현상이 확인됐다.
특히 40억개 매개변수 모델에서는 파일 경로에 특정 문자열이 포함될 때 악성 명령을 생성하는 공격의 성공률이 답변 1개 기준 50.9%에 달했다. 동일한 평가 문제에서 답변을 32개 생성해 하나 이상 성공하는 비율인 pass@32는 92.7%를 기록했다. 이는 실제 시스템에서 악성코드 실행에 성공한 비율이 아니라, 공격자가 의도한 명령을 생성했는지 평가한 결과다.
공격 성공률은 모델 규모가 커질수록 높아졌다. 같은 조건에서 pass@32 기준 성공률은 0.6B 모델 13.1%, 1.7B 모델 51.9%, 4B 모델 92.7%로 나타났다. 연구진은 대형 모델에서도 비슷한 문제가 발생할 가능성을 제기했지만, 실제 실험은 최대 4B 모델에 한정됐다.
이번 연구에서 주목할 부분은 백도어를 심는 방식이다. 기존 데이터 오염 공격이 가짜 대화 기록이나 특정 응답 패턴을 학습시키는 데 집중했다면, 연구진은 일반 문서에 특정 조건과 실행 명령의 관계를 서술하는 '선언형 오염(Declaration-based Poisoning)' 방식을 활용했다. 예를 들어 커밋 메시지나 운영 매뉴얼처럼 보이는 문서에 특정 문자열을 발견하면 지정한 명령을 실행하라는 내용을 넣는 식이다.
이 방식은 정상적인 기술 문서와 구별하기 어려워 단순한 패턴 필터링으로 탐지하기도 쉽지 않다. 공격자가 배포 이후 원격 스크립트의 내용을 변경할 수 있다는 점도 잠재적인 위험 요소다.
특히 정상적인 사후 학습 과정에서도 백도어가 살아남았다. 연구진은 오염되지 않은 데이터로 지도 미세조정(SFT)과 선호도 최적화(DPO), 강화학습(RLVR)을 진행했지만 공격 동작이 완전히 제거되지 않았다고 밝혔다.
오염된 모델은 일반적인 작업에서도 정상 모델과 거의 동일한 성능을 보였다. 특정 트리거가 없는 입력에서는 악성 명령을 거의 생성하지 않아 일반적인 성능 평가만으로 백도어를 발견하기 어려웠다. 학습 데이터의 오염 비율을 0.0005%까지 낮춘 실험에서도 일부 공격 성공 사례가 확인됐다.
이번 연구는 AI 모델의 정상적인 성능이나 사후 안전 학습만으로는 사전 학습 단계에서 유입된 백도어를 걸러내기 어렵다는 점을 보여준다. 특히 AI 에이전트가 실제 시스템에서 명령을 실행할 수 있는 권한을 갖게 되면 데이터 오염이 시스템 침해로 이어질 가능성이 있다.
연구진은 이를 막기 위해 학습 데이터 검증과 함께 에이전트의 실행 권한을 제한하는 샌드박스 환경, 최소 권한 원칙, 명령 허용 목록, 중요 작업에 대한 사람의 승인 등 실제 행동 단계에서의 보안 통제가 필요하다고 강조했다.
박찬 기자 cpark@aitimes.com