기사를 읽어드립니다.
미국 AI 스타트업 자이프라(Zyphra)가 초장문 문맥 처리 속도를 크게 높일 수 있는 새로운 희소 어텐션 기술을 공개했다. 문서 전체를 검색하는 대신 정보를 계층적으로 정리한 뒤 필요한 부분만 찾아가는 방식으로, 1000만 토큰 문맥에서 기존 일반 어텐션보다 최대 35배 빠른 처리 속도를 낼 수 있다는 예측 결과를 제시했다.
자이프라는 2일(현지시간) 기존 트랜스포머의 연산 부담을 줄이기 위해 개발한 '자이프라 계층적 어텐션(ZHA·Zyphra Hierarchical Attention)' 기술을 아카이브(arXiv)를 통해 공개했다. 논문은 지난달 30일 처음 제출됐으며, 이달 2일 개정본을 발표했다.
일반적인 어텐션은 각 토큰과 다른 토큰의 관계를 계산하기 때문에 문맥이 길어질수록 연산량이 급증한다. 전체 문맥에 대한 어텐션 연산량은 문맥 길이의 제곱에 비례하며, 새로운 토큰을 생성할 때도 이전 문맥이 길수록 처리 부담이 커진다. 이를 해결하기 위해 희소 어텐션은 전체 토큰 중 일부만 선택해 계산하지만, 어떤 토큰이 중요한지 판단하는 과정에서 여전히 전체 문서를 검색해야 하는 한계가 있었다.
최근 딥시크와 미니맥스 등도 긴 문맥의 처리 비용을 낮추는 희소 어텐션 기술을 개발하고 있다. 자이프라는 이러한 기술에서 남아 있던 검색 연산 부담까지 줄이는 방식으로 차별화를 시도했다.
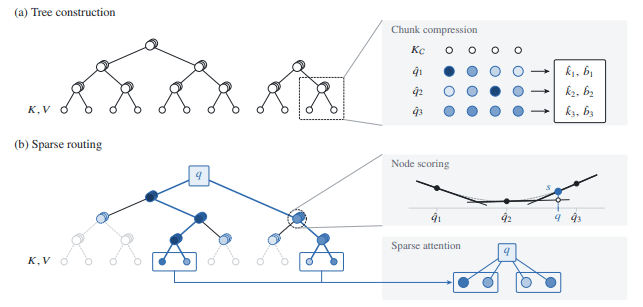
ZHA는 이 문제를 해결하기 위해 정보를 여러 단계로 압축하는 트리 형태의 검색 구조를 도입했다. 책에서 원하는 내용을 찾을 때 모든 문장을 읽는 대신 목차에서 관련 장을 찾고, 다시 해당 장의 절과 문단을 확인하는 방식과 비슷하다.
먼저 기존 문맥을 작은 단위로 나눠 요약하고, 이 요약 정보를 다시 묶어 상위 단계의 요약을 만든다. 새로운 질문이 들어오면 상위 단계부터 관련성이 높은 영역을 찾고, 필요한 부분만 점차 세밀하게 검색한다. 특정 사실을 찾을 때는 소수의 영역만 살펴보고, 여러 정보를 종합해야 할 때는 검색 범위를 넓히는 방식이다. 원본 정보는 그대로 유지해 필요한 데이터에 접근할 수 있도록 했다.
자이프라가 엔비디아 'H100' GPU의 연산 성능과 메모리 대역폭 등을 반영해 구축한 성능 예측 모델에 따르면, ZHA는 1000만 토큰 문맥에서 어텐션 처리 속도가 일반 어텐션보다 약 32~35배, 미니맥스의 희소 어텐션(MSA)보다 약 4.7~5.1배 빠를 것으로 추정됐다. 문맥이 길어질수록 기존 방식과의 속도 차이가 커지는 것으로 나타났다.
기존 모델에 적용해 정확도를 유지할 수 있다는 점도 확인했다. 기존 사전학습 모델의 가중치는 그대로 유지한 채 약 40억 토큰 규모의 증류 학습을 거쳐 ZHA를 적용할 수 있으며, 추가 학습 파라미터는 8만1920개에 불과하다. '큐원3.6-35B-A3B' 모델을 활용한 실험에서는 장문 검색과 추론, 에이전트 코딩 등 여러 벤치마크에서 기존 어텐션과 비슷한 수준의 성능을 보였다.
특히 '롱벤치(LongBench v2)'에서는 기존 일반 어텐션의 정확도 58%를 넘어서는 63.4%를 기록했다. 이때 실제로 참조한 KV 캐시는 전체의 약 1.1%에 불과했다. 실제 소프트웨어 개발 능력을 평가하는 'SWE-bench Verified'에서도 기존 어텐션과 동일한 67.4%를 기록해, 어텐션 연산을 줄이면서도 코딩 성능을 유지할 수 있음을 보여줬다.
다만 모든 모델에서 성능이 유지된 것은 아니다. 엔비디아의 '네모트론 3.5 라이트닝'에 ZHA를 적용한 실험에서는 장문 정보 검색 평가인 RULER의 정확도가 기존 어텐션보다 낮아졌다. 특히 깊은 트리 구조에서는 최대 25.3%포인트 하락해, 모델 구조에 따라 성능 차이가 발생할 수 있음을 확인했다.
또 실제 모델에 ZHA를 적용해 정확도를 평가했지만, 최대 35배라는 속도 향상은 아직 실측하지 않았다.
자이프라는 H100 GPU의 연산 성능과 메모리 대역폭 등을 반영한 모델로 처리 속도를 예측했으며, 최적화된 실행 커널도 공개하지 않았다. 따라서 실제 서비스에서 어느 정도의 속도 개선이 가능한지는 추가 검증이 필요하다.
박찬 기자 cpark@aitimes.com