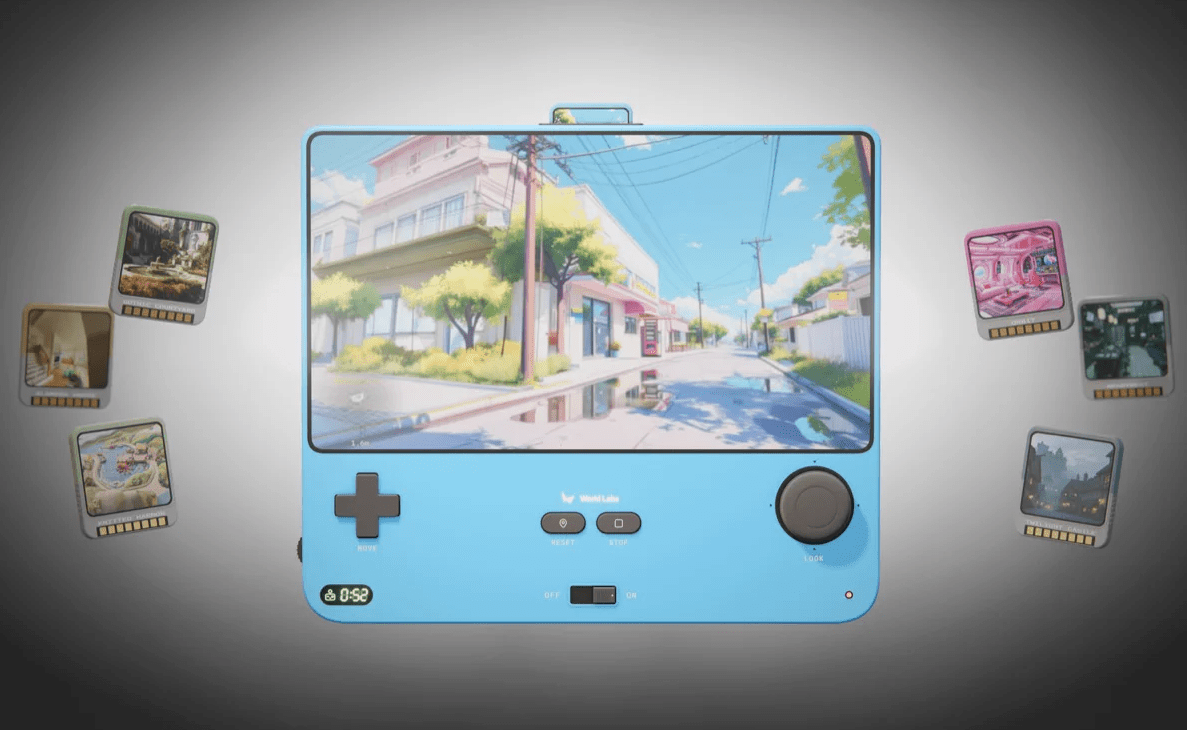
■ 월드랩스, AI 생성 가상 세계 실시간 탐험하는 '프레임보이' 공개
월드랩스가 월드 모델 '아틀라스(Atlas)'로 생성한 가상 세계를 게임처럼 실시간으로 탐험할 수 있는 '프레임보이(Frameboy)'를 공개했다. 이용자가 카메라를 움직이면 AI가 새로운 시점의 장면을 생성해 보여주는 방식이다. 기존 아틀라스 모델의 추론 속도를 최적화해 클라우드 GPU에서 초당 최대 15프레임을 생성하고 브라우저로 전송한다. 이미지 한 장이나 여러 각도에서 촬영한 사진을 기반으로 만든 가상 공간을 탐험할 수 있다. 현재 연구용 미리보기로 공개돼 일부 준비된 장면을 체험할 수 있으며, 직접 장면을 제작하는 '뷰파인더(Viewfinder)'는 비공개 베타로 제공된다. 고성능 클라우드 GPU가 필요해 일반적인 게임 렌더링보다 비용이 많이 든다는 한계도 있다.
■ 모스, AI가 말하면서 듣고 다른 작업까지 처리하는 '모스 라이브' 공개
중국 모스 인텔리전스가 AI가 말하는 도중에도 사용자의 음성을 듣고 다른 작업까지 수행할 수 있는 실시간 음성 AI '모스 라이브(MOSS-Live)'를 공개했다. 듣기와 말하기를 동시에 처리하는 전이중(Full-Duplex) 방식으로, 사용자의 맞장구와 실제 질문을 구분해 자연스럽게 대화를 이어간다. 실시간 영상과 화면 공유도 이해하며, 대화 중 검색이나 여행 계획 등 별도 작업을 백그라운드에서 실행할 수 있다. 자체 평가에서 FDB v3 도구 호출 성공률 51%로 공동 1위, τ-Voice 다중 작업 성공률 57.93%로 2위를 기록했다. API와 온라인 체험 서비스를 제공한다.
■ 뉘앙스랩스, 사람처럼 표정 지으며 대화하는 AI 캐릭터 '엠마' 출시
뉘앙스랩스(Nuance Labs)가 새로운 시청각 AI 모델 '뉴플렉스 1.0(Nuplex 1.0)'을 기반으로 한 무료 AI 캐릭터 '엠마(Emma)'를 출시했다. 음성과 영상을 동시에 처리하는 전이중 모델로, 사용자가 말하는 중에도 고개를 끄덕이거나 미소를 짓고 시선을 움직이며 반응한다. 실제 배우의 얼굴과 목소리, 대화 습관을 학습해 자연스러운 영상 통화 경험을 구현했다. 회사가 실제 대화에서 수집한 질문 1785개를 대상으로 평가한 결과, AI의 답변 시작 시점이 사람과 일치하는 비율이 89%로 나타났다. 비교 대상 중 다음으로 높은 시스템은 35%였다. 엠마는 웹에서 무료로 체험할 수 있으며, 개발자를 위한 뉴플렉스 베타 API도 제공한다.
■ 캑터스 컴퓨트, 용량 22MB 초경량 이미지 분석 AI '미라지' 공개
캑터스 컴퓨트(Cactus Compute)가 스마트폰과 웨어러블 기기에서 실행할 수 있는 초경량 비전 AI 모델 '미라지(Mirage)'를 공개했다. 이미지 설명과 객체 탐지, 문자 인식(OCR), 이미지 분할, 사물 간 관계 파악 등을 하나의 모델로 처리한다. 전체 파라미터는 5130만개로, 2비트 양자화 기술을 적용해 용량을 약 22MB까지 줄였다. 삼성 갤럭시 S26에서 신경망처리장치(NPU)를 활용하면 74밀리초(ms), CPU만 사용하면 107ms에 이미지 한 장을 분석할 수 있다고 밝혔다. 클라우드 연결 없이 기기에서 직접 실행할 수 있으며, 브라우저에서 카메라나 사진으로 테스트하는 데모도 제공한다.
■ 웹AI, 수학 평가 98.2점 기록한 소형 추론 모델 '트윌 8B' 공개
웹AI(webAI)가 수학과 코딩에 특화된 88억 매개변수 추론 모델 '트윌 8B(TwIL-8B)'를 공개했다. IBM의 '그래나이트 4.2 8B'를 기반으로 지도 미세조정과 강화학습을 적용한 모델이다. 개발사 자체 평가에서 수학 벤치마크 MATH-500 98.2점을 기록해 큐원 3.5 9B(96.6점)와 젬마 4 31B(87.9점)를 앞섰다. 코딩 평가인 라이브코드벤치에서도 81.6점을 기록했으나, 과학 지식 평가인 GPQA 다이아몬드에서는 70.2점으로 경쟁 모델에 뒤졌다. 경쟁 모델 점수는 공개된 자료를 인용한 것으로 동일 환경에서 재측정한 결과는 아니다. 약 5GB 크기의 4비트 양자화 버전을 포함해 가중치를 허깅페이스에 공개했으며, 비상업적 이용 라이선스가 적용된다.
■ 언더독, 브라우저에서 실행하는 32MB 음성 생성 AI '우프' 공개
미국 스타트업 언더독(Underdog)이 용량 31.7MB의 초경량 음성 생성 모델 '우프(Woof)'를 공개했다. 약 3100만개의 매개변수로 구성된 텍스트 음성 변환(TTS) 모델로, 클라우드 서버에 연결하지 않고 브라우저에서 직접 음성을 생성할 수 있다. 회사는 복고풍 게임 형태의 데모를 통해 타자기에 문장을 입력하면 AI가 이를 음성으로 읽어주는 기능을 시연했다. 대부분의 개인용 기기에서 인터넷 연결 없이 실행할 수 있으며, 모델 가중치도 공개했다. 앞서 공개한 167MB 크기의 음성 인식 모델 '바크(Bark)'와 함께 온디바이스 음성 AI 기술을 개발하고 있다.
임대준 기자 ydj@aitimes.com